


Аналитика
Как посчитать ROI от внедрения ИИ ещё до старта проекта
[читать статью]
Андрей Масалович (КиберДед)
Президент Консорциума «Инфорус», разработчик платформы интернет-разведки Avalanche, кандидат физико-математических наук, подполковник ФАПСИ в отставке
Сотрудник загрузил в ИИ-чат договор, чтобы быстрее найти в нём пункт про ответственность. Через минуту он получил ответ, закрыл вкладку и пошёл дальше. Договор остался на чужих серверах.
Случилось ли что‑то? Нет. Но не благодаря усилиям, которые вы приложили к защите своих данных, а скорее вопреки. С 1 сентября 2026 у этого сюжета появляется юридическое измерение.
Российское регулирование больших моделей запущено: закон подписан 26 июля 2026. Его основные пункты вступают в силу уже с 1 сентября, обязанности разработчиков — с 1 марта 2027.
Правительство получит право определять случаи, когда допустимы только суверенные или национальные модели. Но техническая сторона вопроса остаётся нерешённой: привычное определение доверенной системы к нейросети не применяется, потому что её поведение нечем измерить.
26 июля 2026
Подписание первого закона об ИИ в России
1 сентября 2026
Основные пункты закона вступают в силу
1 марта 2027
Обязанности разработчиков вступают в силу
До появления нейросетей считалось, что доверенная среда — значит изолированная: замкнуть контур, проверить технику, проверить людей. Дальше остаётся следить, чтобы внутрь не занесли лишнего.

Тридцать лет назад доверенная среда означала изолированную. На больших системах такой контур уже не построишь, поэтому мир давно живёт по другому правилу: доверенное — значит измеряемое. Самолёты падают, но известно, в какой доле полётов. Двигатель отказывает, но наработка на отказ посчитана. С нейросетью это правило не работает: измерять нечем.

Здесь и находится настоящая проблема, а не в страшилках про восстание машин. Инженерная культура последних тридцати лет построена на том, что риск можно посчитать заранее: заложить в бюджет, застраховать, вынести в SLA. Нейросеть в эту рамку не помещается. Она не даёт гарантии, что на пятитысячном запросе поведёт себя так же, как на первом.
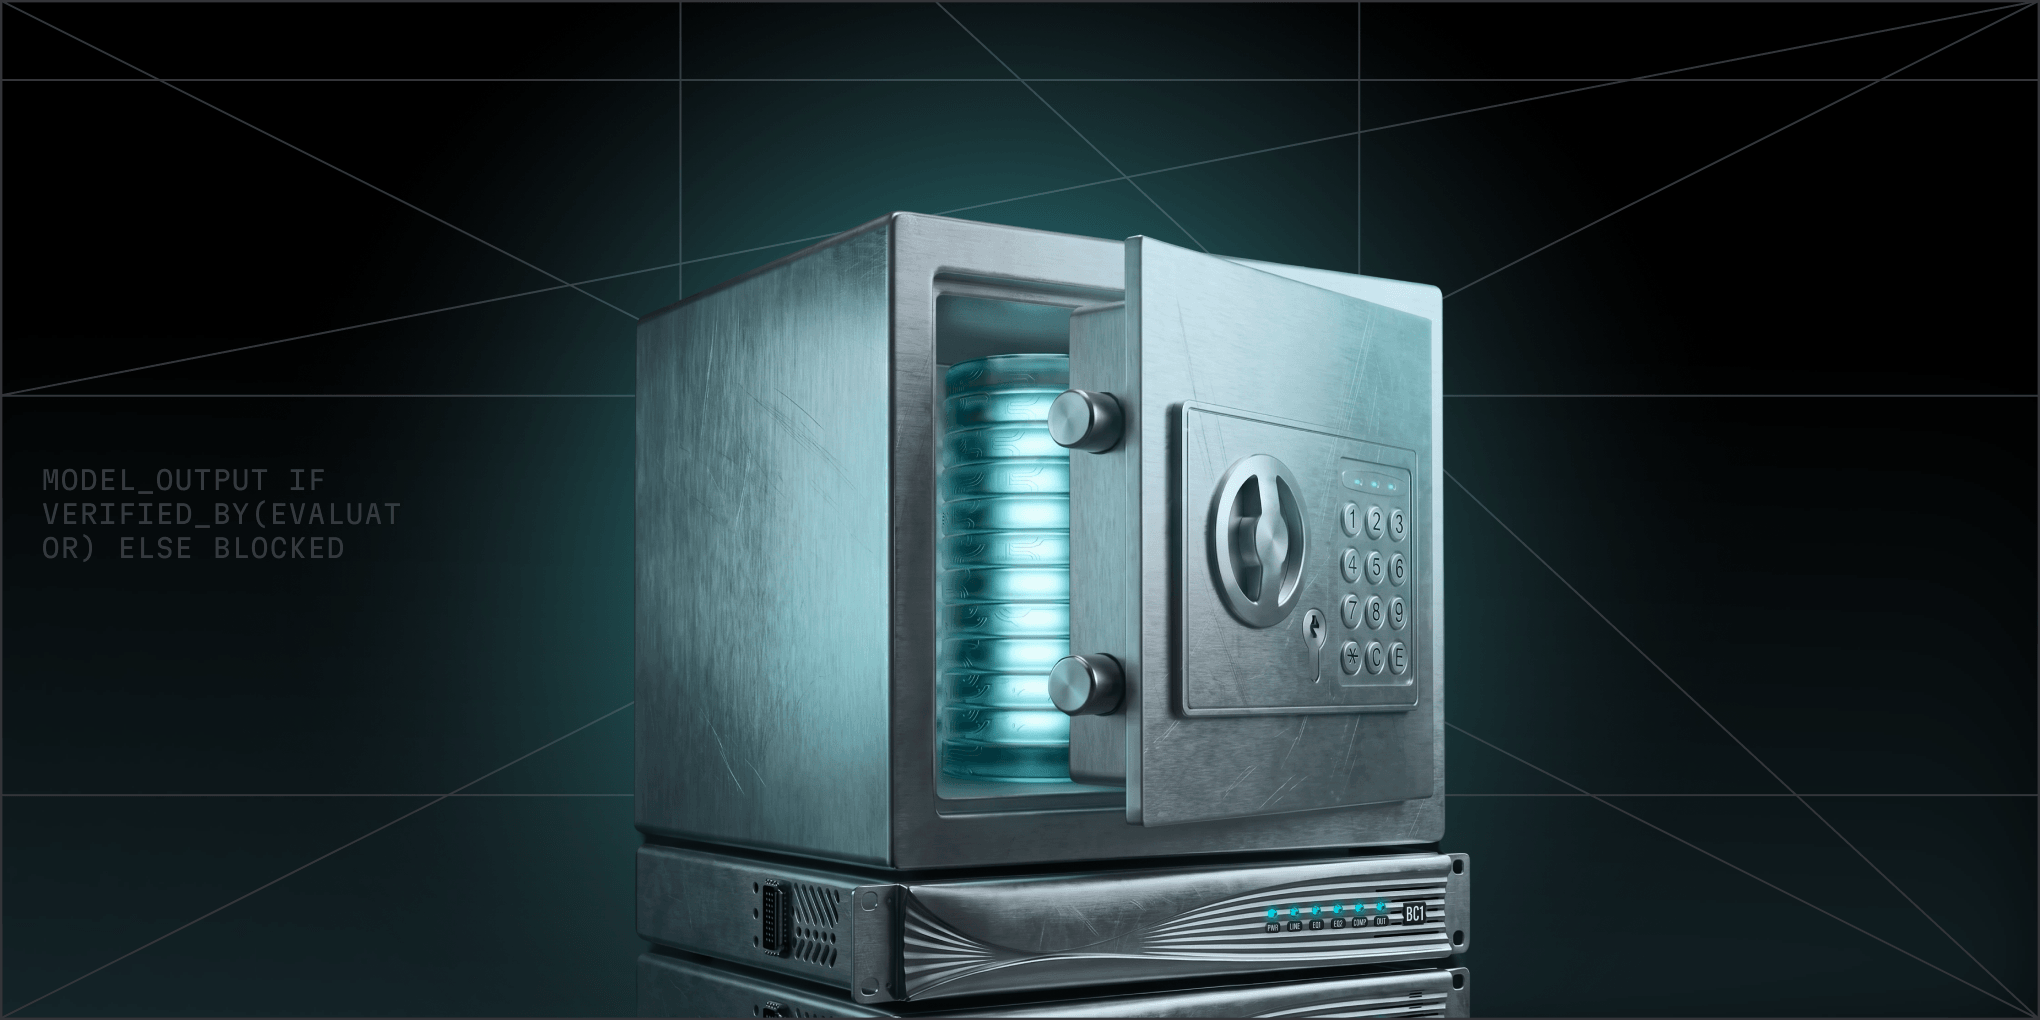
Доверенная среда для ИИ — вычислительный контур, в котором данные не покидают периметр компании, поведение модели контролируется отдельными модулями-оценщиками, а критичные решения проходят через сравнение нескольких моделей и подтверждение человеком.
Разберём каждый – и сразу отметим, что из этого сегодня выполнимо.
Вычисления должны идти на оборудовании, которое вам подконтрольно. Раньше это упиралось в стоимость: специализированный сервер начинался от нескольких миллионов рублей.
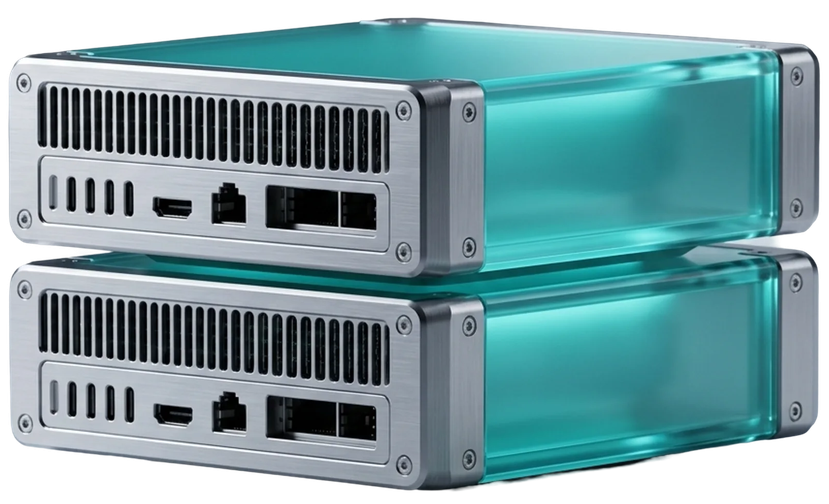
Сейчас порог ниже. Настольные системы вроде NVIDIA DGX Spark дают один петафлопс при 240 Вт и 128 ГБ общей памяти, чип GB10 Grace Blackwell, SSD до 4 ТБ; цена стартовала с 3 999 $ и была поднята до 4 699 $ из-за дефицита памяти, но всё ещё остаётся приемлемой. Этого хватает, чтобы держать локально модель на 30–40 миллиардов параметров и оставить память под данные.
NVIDIA DGX Spark
Пример расчёта параметров железа
$3999$4699
из-за дефицита памяти
1 PFLOPS
вычислительная мощность
240 Вт
энергопотребление
128 ГБ
общая память
4 ТБ
SSD-накопитель
30–40 млрд
параметров поддерживает
Локальное железо покупают, когда отвечают на вопрос «зачем локально», а не наоборот. Если данные в задаче открытые, изолированный контур — страховка от риска, которого пока нет.
Закрытые данные приходят на втором этапе: пилот показал результат, и в него понесли настоящую информацию, которая является конфиденциальной. Вот тогда и возникает вопрос про периметр и доверенную среду.
В таком случае компания закупает собственное оборудование (или выделяет уже существующее), создаёт закрытый контур, недоступный извне, и разворачивает ИИ-модель локально. Далее за две недели можно проверить, что задача вообще решается, а после приступить к масштабированию.
Отдельные сервисы, которые следят за поведением модели и отвечают на вопрос, можно ли доверять конкретному ответу прямо сейчас. Это то место, где собственная разработка даёт больше: оценщик пишется под предметную область и под конкретный регламент.
Формальная проверка на закладки и недокументированные функции.
Закладка — намеренно оставленный фрагмент, который делает что‑то, не описанное в документации: открывает скрытый доступ или срабатывает по условию. С обычным кодом это проверяемо, есть исходники и методики. С нейросетью проверять нечего: закладку можно вложить не в программу, а в обучающие данные, и модель будет вести себя нормально, пока не сработает определённый триггер.
В России этой темой предметно занимается Институт системного программирования РАН, но стадия ранняя, и законченного результата нет ни у кого в мире. Получить код со штампом «проверено, закладок нет, галлюцинации исключены» сегодня негде. Этот шаг закрыть нечем.
Первый вариант — выбирать вендора из списка и опираться на Кодекс этики в сфере ИИ. Второй — запускать несколько моделей на одной задаче и принимать решение по сходимости ответов, как в спорте, где субъективную оценку выставляют несколько судей.
Российский закон — первый рамочный документ, с которым бизнесу придётся работать; отраслевую конкретику для медицины, промышленности и ИТ ещё предстоит написать.
Итого: шаги 1 и 2 закрываются своими силами уже сейчас, шаг 4 — частично и за деньги, шаги 3 и 5 не закрыты ни у кого.
В июле 2025 года MIT Project NANDA выпустил отчёт «The GenAI Divide: State of AI in Business 2025». Вывод разошёлся по деловым изданиям: около 95% организаций не получили от генеративного ИИ измеримого эффекта на прибыль. И причина везде называется одна: дело не в качестве моделей, а в том, как компании их внедряют.
В длинной перспективе компания теряет собственную воронку роста специалистов и попадает в зависимость от внешнего рынка труда, который к тому моменту тоже будет пустым.
Модель знает про вас ровно то, что вы записали. Если один справочник ведут три подразделения и у каждого своя версия, нейросеть выберет одну и уверенно на неё сошлётся.
Но справочники — это меньшая часть проблемы. Большая часть знаний компании нигде не записана. Для нового сотрудника это неудобство, он спросит соседа. Для системы это отсутствие данных: она на ваших совещаниях не была и в чужую переписку не заглянет.
Отсюда простая проверка, которую мы предлагаем сделать до любого разговора о технологиях. Может ли новый сотрудник в первый рабочий день закрыть типовую задачу, ничего ни у кого не спрашивая? Если нет, то и внедрять пока нечего: сначала записывается то, что передаётся из уст в уста.
Мы сейчас проходим это на себе: строим внутренний слой памяти, где данные хранятся так, чтобы их читал не только человек. Самым трудным оказалось назначить владельца каждому блоку данных и договориться, что происходит, когда две системы разошлись.

Пройдите по нему до того, как обсуждать бюджет на ИИ.
Анализ процессов
Разработка решения
Тестирование и правки
Демо и масштабирование
Оставьте заявку — мы свяжемся в течение рабочего дня, обсудим ваши задачи и предложим формат AI-спринта
до рабочего прототипа на ваших данных
рисков за счет теста до внедрения
на рынке заказной разработки
Аналитика
[читать статью]

Аналитика
[читать статью]

Корпоративные знания
[читать статью]

Тренды
[читать статью]
ИИ-агенты
[читать статью]

ИИ-агенты
[читать статью]

Производство
[читать статью]

Производство
[читать статью]
